コラム
RAGとは?AIに社内文書を読ませても、精度が上がらない理由
- 生成AI
- RAG
- AI顧問
社内の規程やマニュアルをAIに読み込ませ、質問すると答えが返ってくる。こうした仕組みをRAG(Retrieval-Augmented Generation/検索拡張生成)と呼びます。生成AIを社内で使う方法として、RAGを検討する企業が増えています。
この記事では、弊社の事例をもとに、RAGの仕組みと、精度が上がらない原因、AIを選ぶ前に決めておくべきポイントを解説します。
RAGとは(検索拡張生成の仕組み)
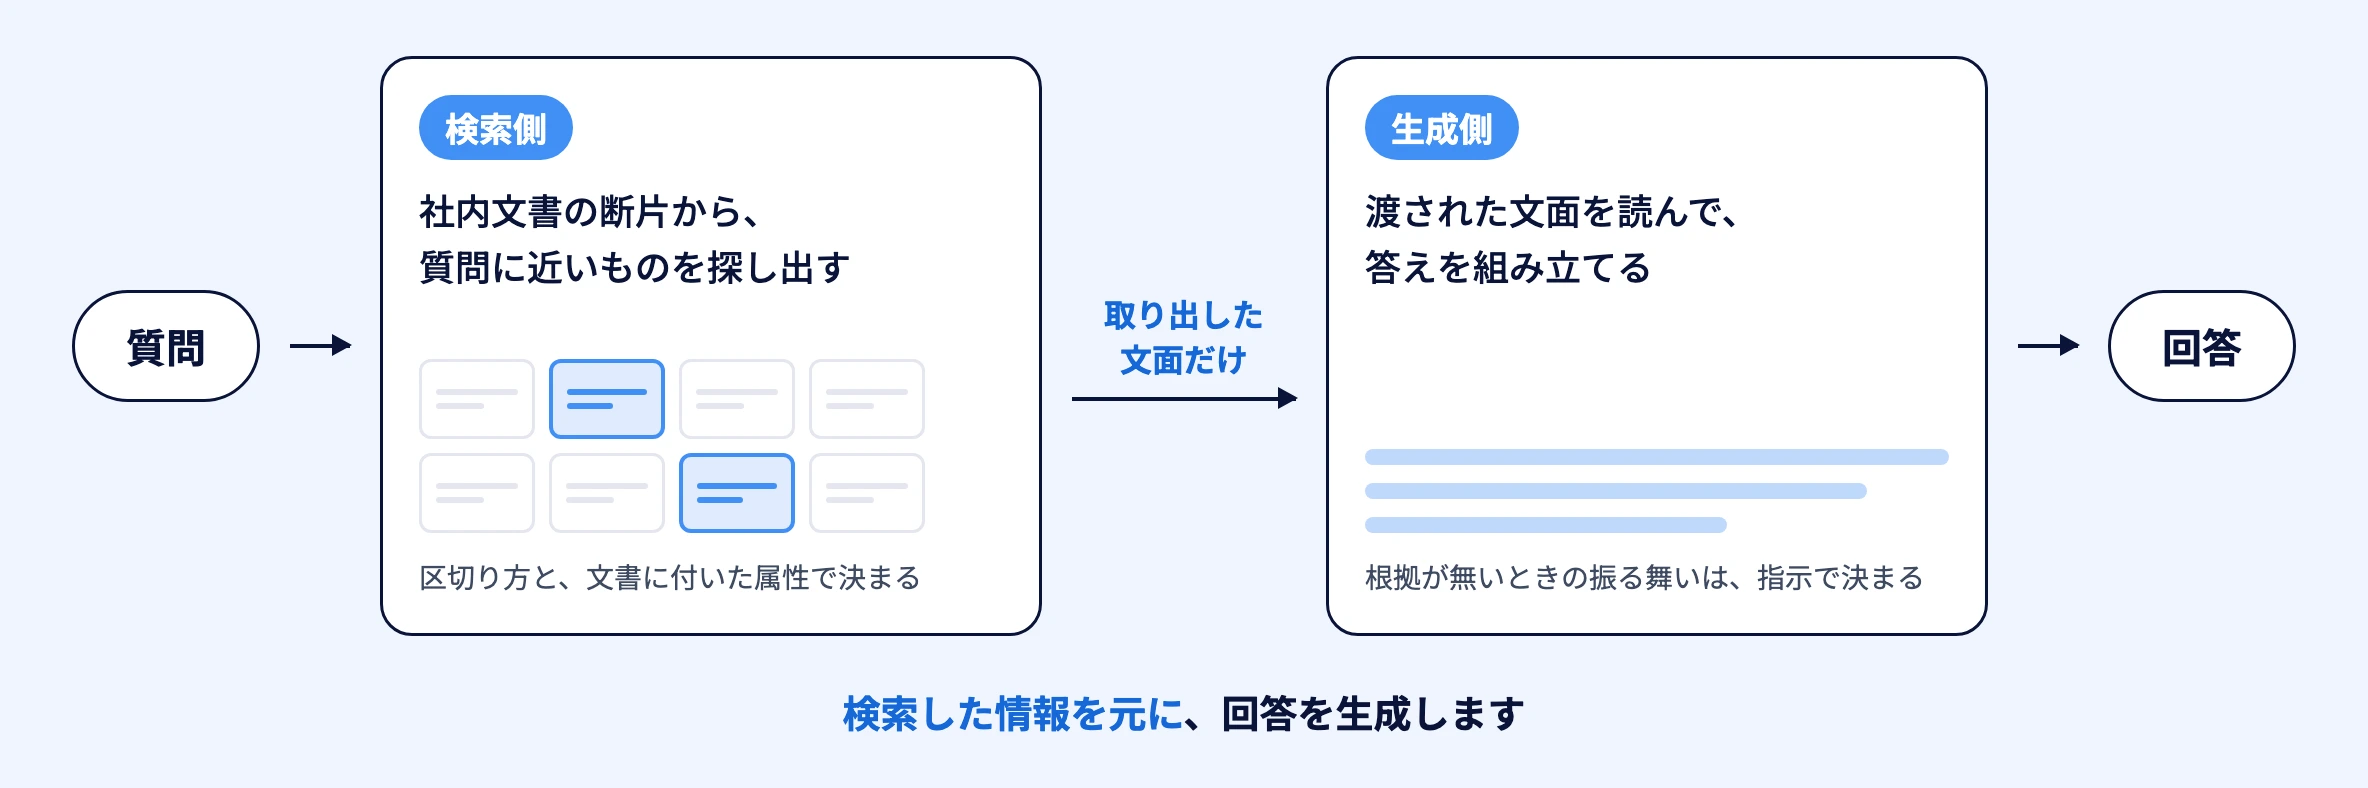
RAGでは、AIが自分の学習で覚えた知識ではなく、検索した内容をもとに回答を生成します。
処理は大きく二段階に分かれます。1つめの、質問に関連する文書を探し出す部分を検索側、2つめの、取り出した文面から回答を組み立てる部分を生成側と呼びます。回答の精度が出ないときは、検索側と生成側のどちらに原因があるのかを先に切り分ける必要があります。
導入のポイント
弊社ではまず、データを整備し、利用スコープを整理し、成果をどう測るかを決めます。いずれもAIモデルを選ぶ前に決められる内容です。
データの整備
検索側が扱えるように、文書そのものと、その置き場を整えます。
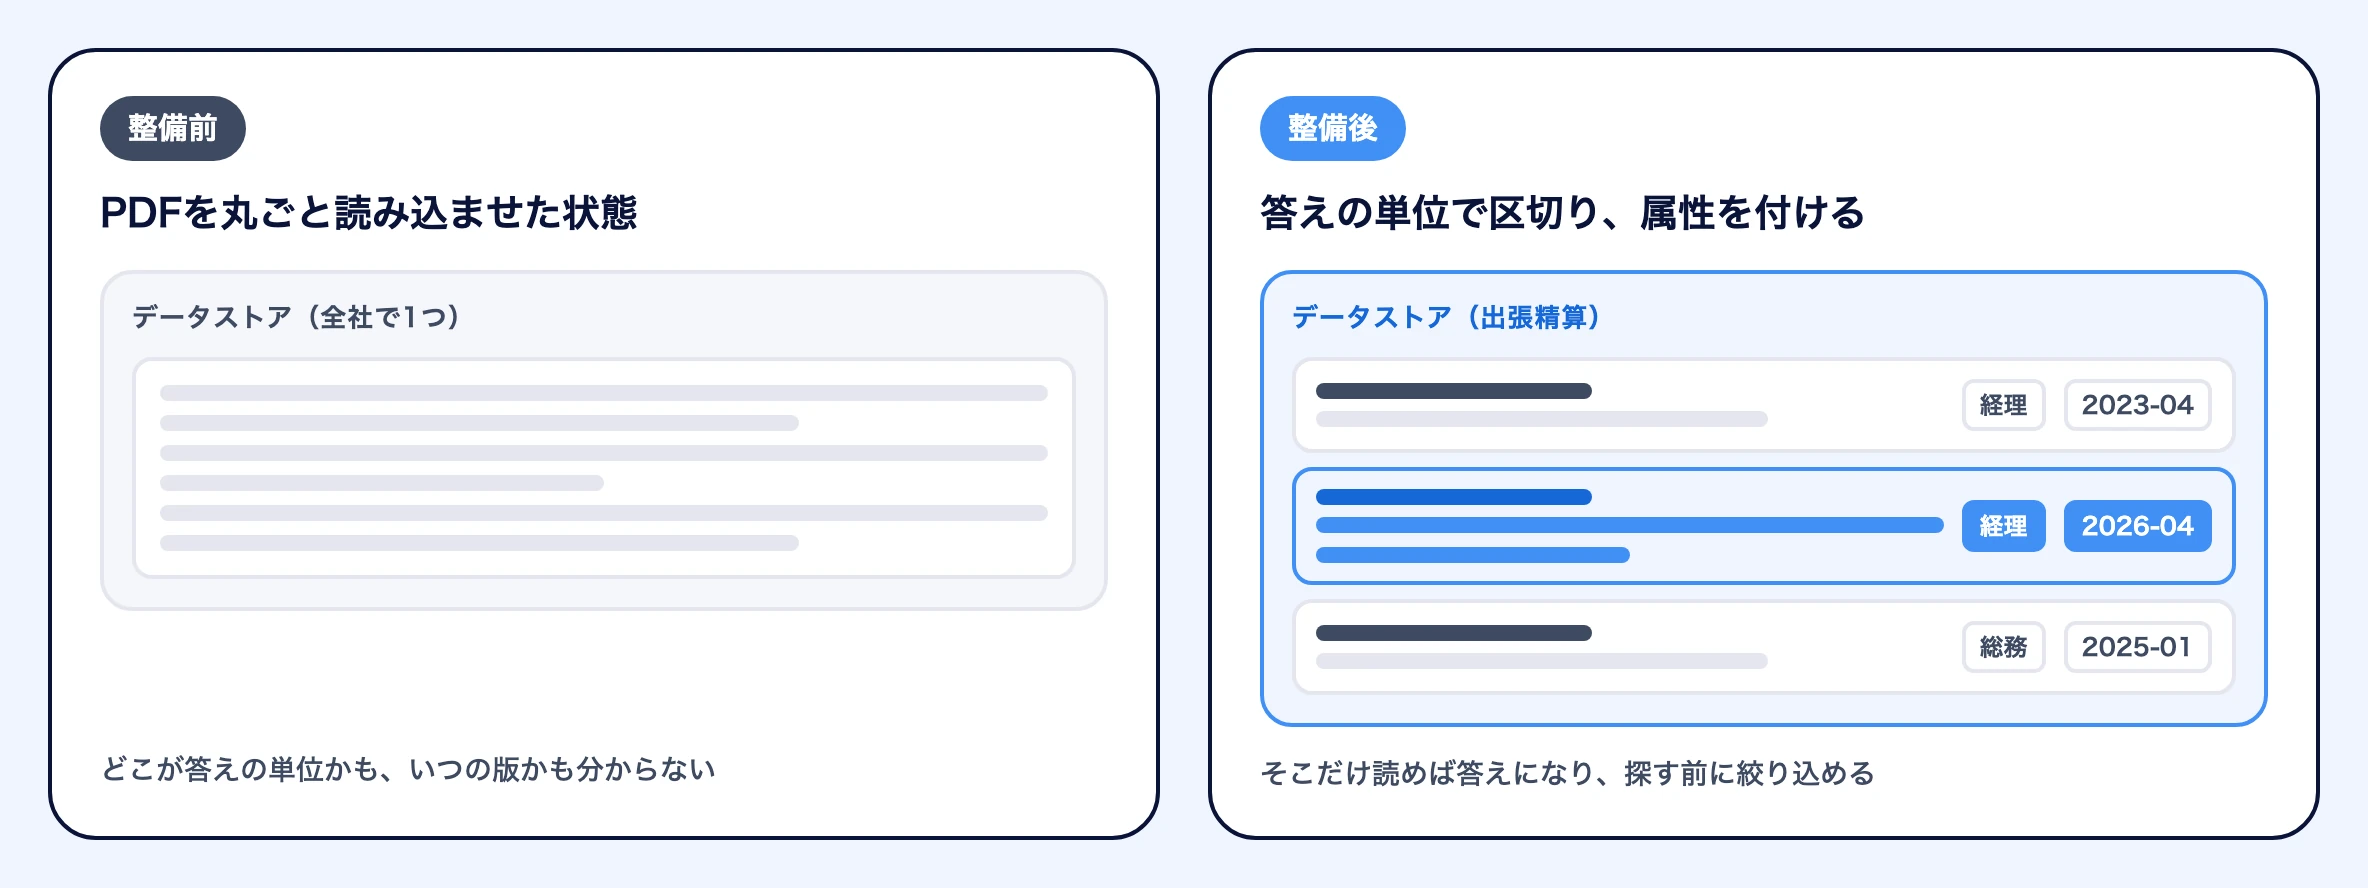
- ユースケース単位でデータストアを分ける。出張精算と情報システムの手順のように、探す先が違う問い合わせは、検索する範囲をそれぞれに限定します。1か所にまとめないことで、関係のない文書が候補に混ざらなくなります。
- 答えの単位で区切る(チャンク分割の設計)。見出し・条番号・別表を手掛かりに、そこだけ読めば答えになる長さで区切ります。
- 文書に属性を付ける(メタデータの付与)。文書種別・部門・版・施行日・社外に出してよいかの5つを決めると、探す前に候補を絞れます。旧版を削除できない場合は、参照対象から外す印を付けます。
利用スコープの整理
すべての業務を対象に、すべての社内資料の検索精度をすぐに上げることは、難易度がとても高くなります。対象の業務が絞られていれば、必要な文書の量も、探し方も定義しやすくなります。「社内のことなら何でも答えるAI」ではなく、「情報システム部門のヘルプデスクをAIで支援する」というところまで、目標のスコープを具体化します。
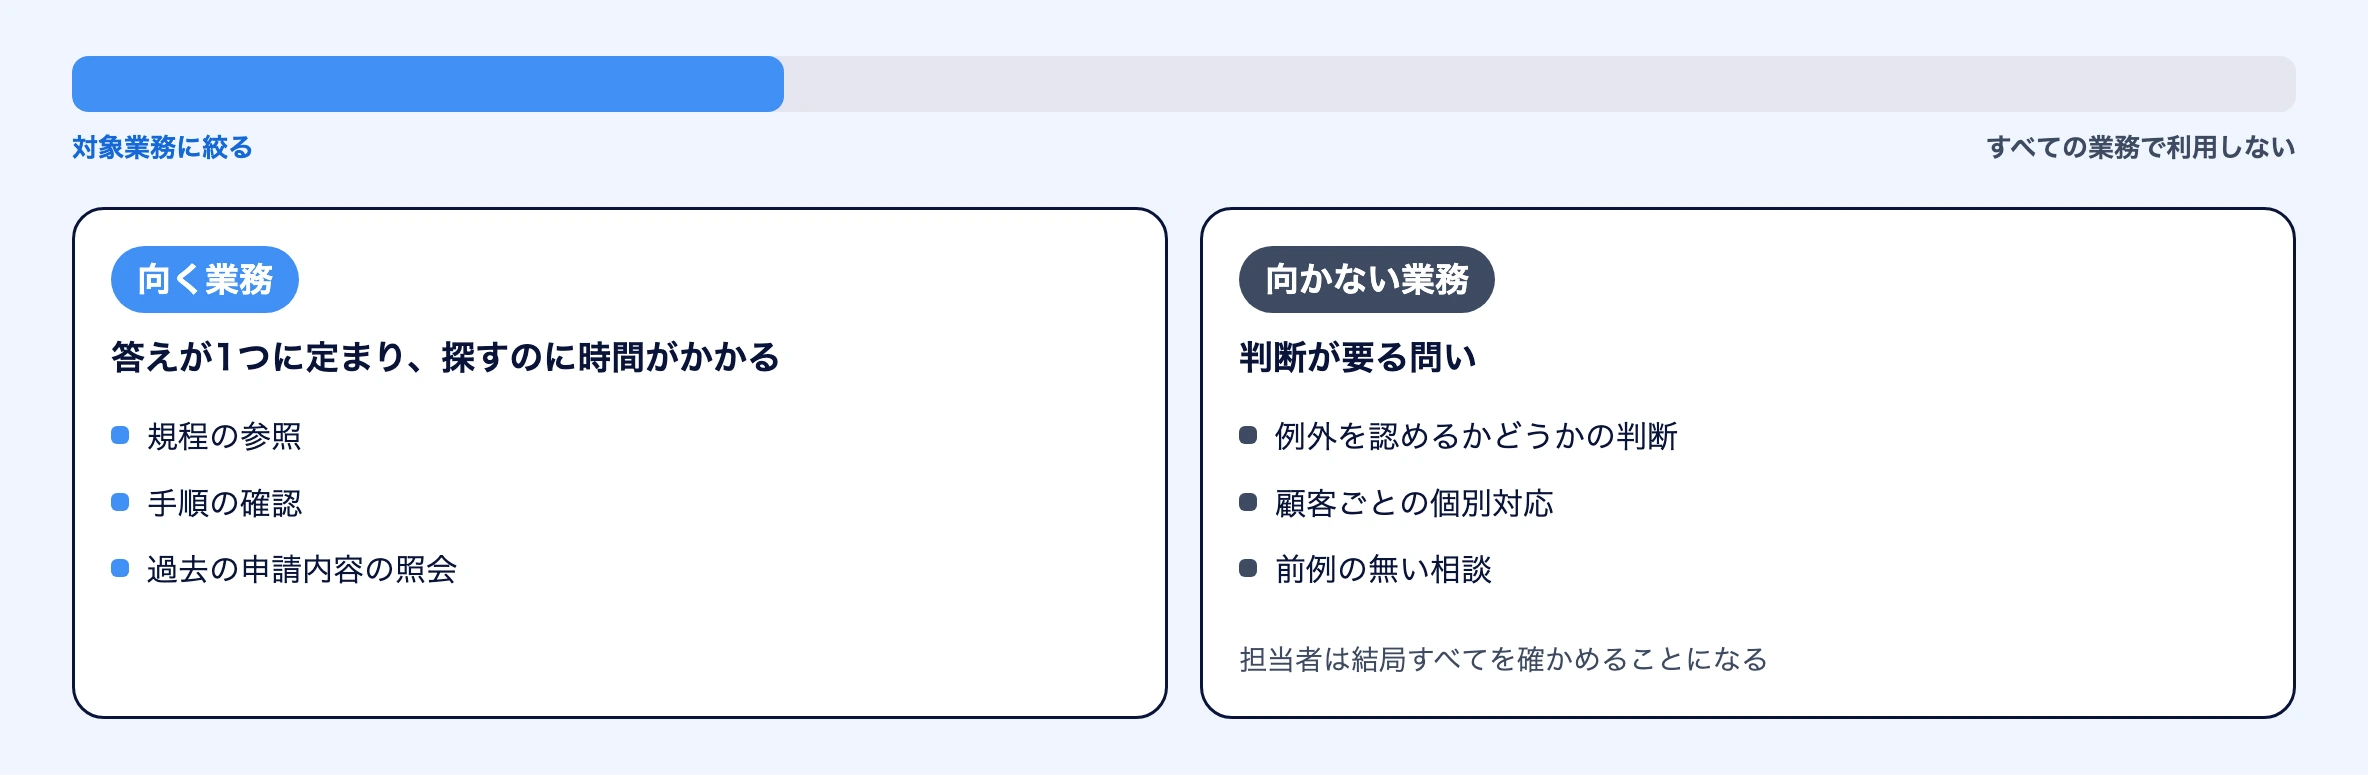
- 対象業務を絞る。効率化しやすいのは、答えが1つに定まり、なおかつ探すのに時間がかかっている業務です。規程の参照、手順の確認、過去の申請内容の照会が当てはまります。判断が必要な質問に当てると、担当者が結局すべてを確かめることになりかねません。
- 答えられる範囲を決める。見つからなければ「分かりません」と返すこと、答えには出典を添えることを、回答の方針として先に決めます。失敗が「間違った答え」ではなく「答えられなかった」という形で表に出ます。
成果を測る
RAGを直したあとに良くなったかどうかを、あとから判断することはできません。
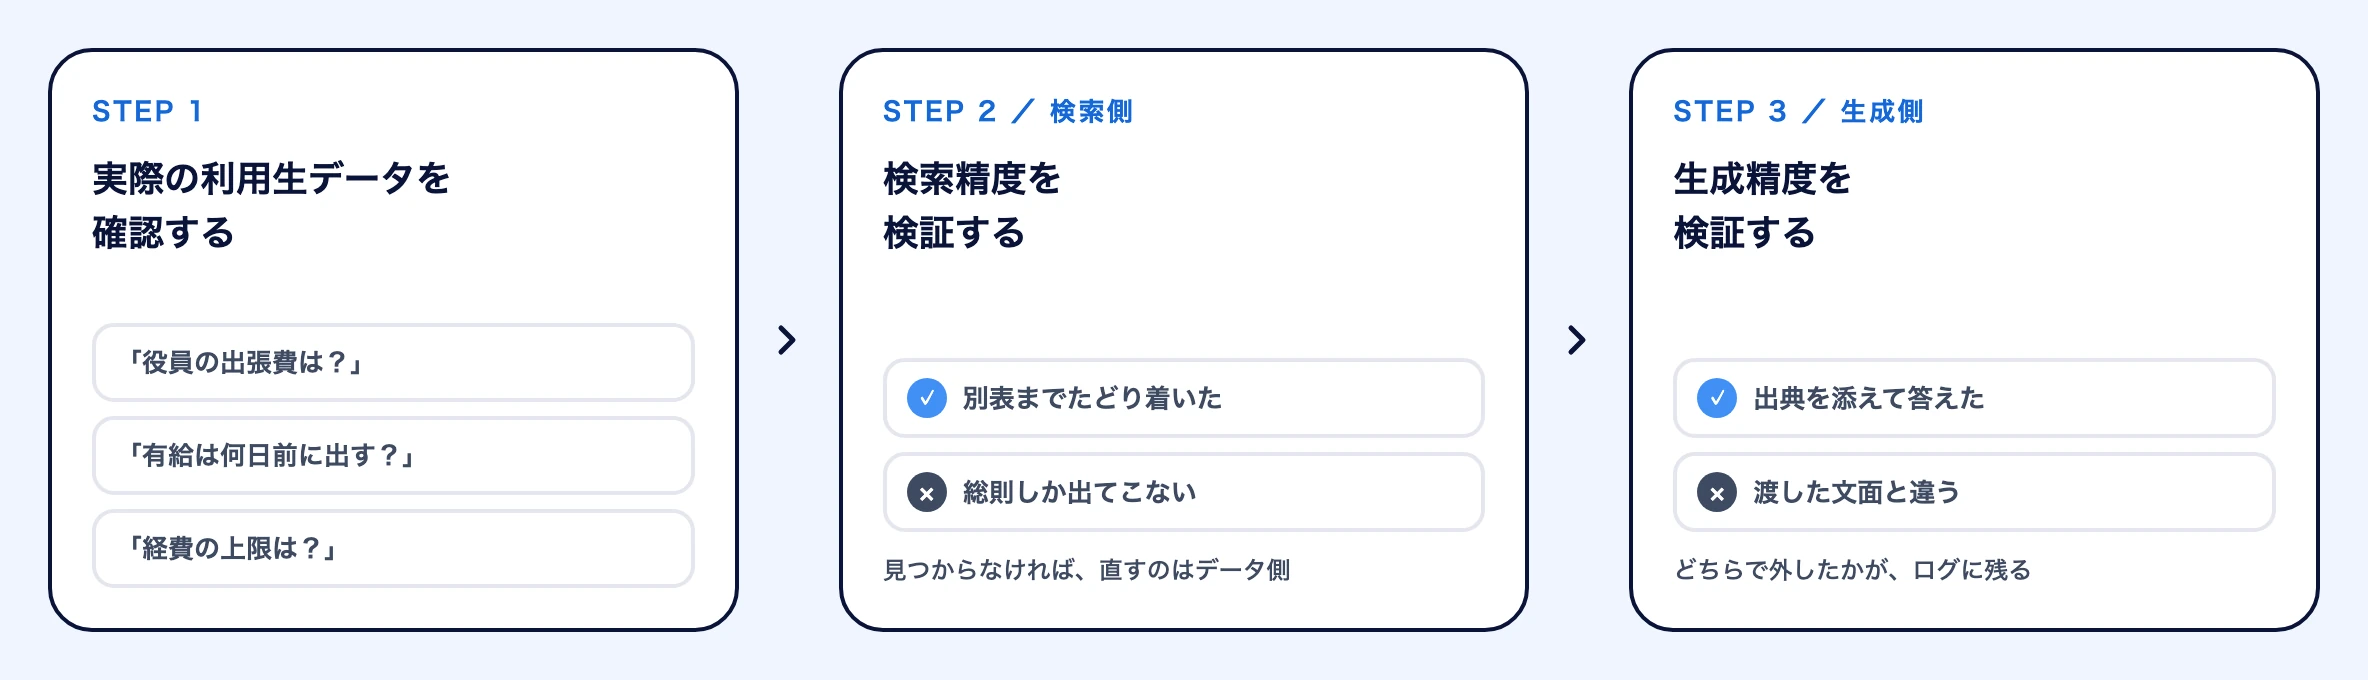
- 評価用の質問を先に集める。まず、現場に実際に届いた質問を、こちらで選ばずに集めます。自動で評価する仕組みを先に作り、変更を一つずつ試します。なお、こちらで選んだ質問で測った数字が本番では再現しない点は、生成AIのPoCと同じです。
- 検索側と生成側を分けて数える。探し出せなかったのか、探し出したうえで答えを外したのか。どちらだったのかが履歴に残る形で、ログを保持します。
まとめ
- データがAIにとって検索しやすい形で保たれているかを確認しましょう。
文書の置かれ方と、取り出す単位の設計に課題があることが多いため、モデルを新しくしても結果は変わりません。まず見るべきなのは、データの構造とドキュメントの管理方法です。 - 業務の対象を絞ってテストしましょう。
「社内のことなら何でも答えるAI」を目標に置くのではなく、どの業務をどのように解決すれば人的コストが減るのかを整理します。 - 計測の仕組みを用意し、PoCで精度を検証しましょう。
現場に実際に届いた質問をもとに、回答にどのくらいの精度が必要なのかという基準を先に設計します。この基準がなければ、良くなったのかを判定できず、検索側と生成側のどちらを直すのかも切り分けられません。
フィード株式会社では、RAGの構築、AIエージェントの開発、AIシステム開発を数多く手掛けています。AIの精度にお悩みの際は、ぜひ一度ご相談ください。
ライター
小林昌太郎 / フィード株式会社 代表取締役CEO
新卒で富士通Japanに入社し、自治体向けのシステム導入と自社プロダクト開発を担当。コインチェックで金融基盤・金融犯罪対策システムの開発、ストックマークで自然言語処理プロダクトのリードエンジニア、グラファーで生成AIプラットフォーム等の新規事業開発に従事したのち、フィード株式会社を創業。