コラム生成AI
LLMO対策とは?SEOとの違いと、ChatGPTやAI Overviewsで根拠に選ばれるためにやること
- LLMO
- SEO
- AI Overviews
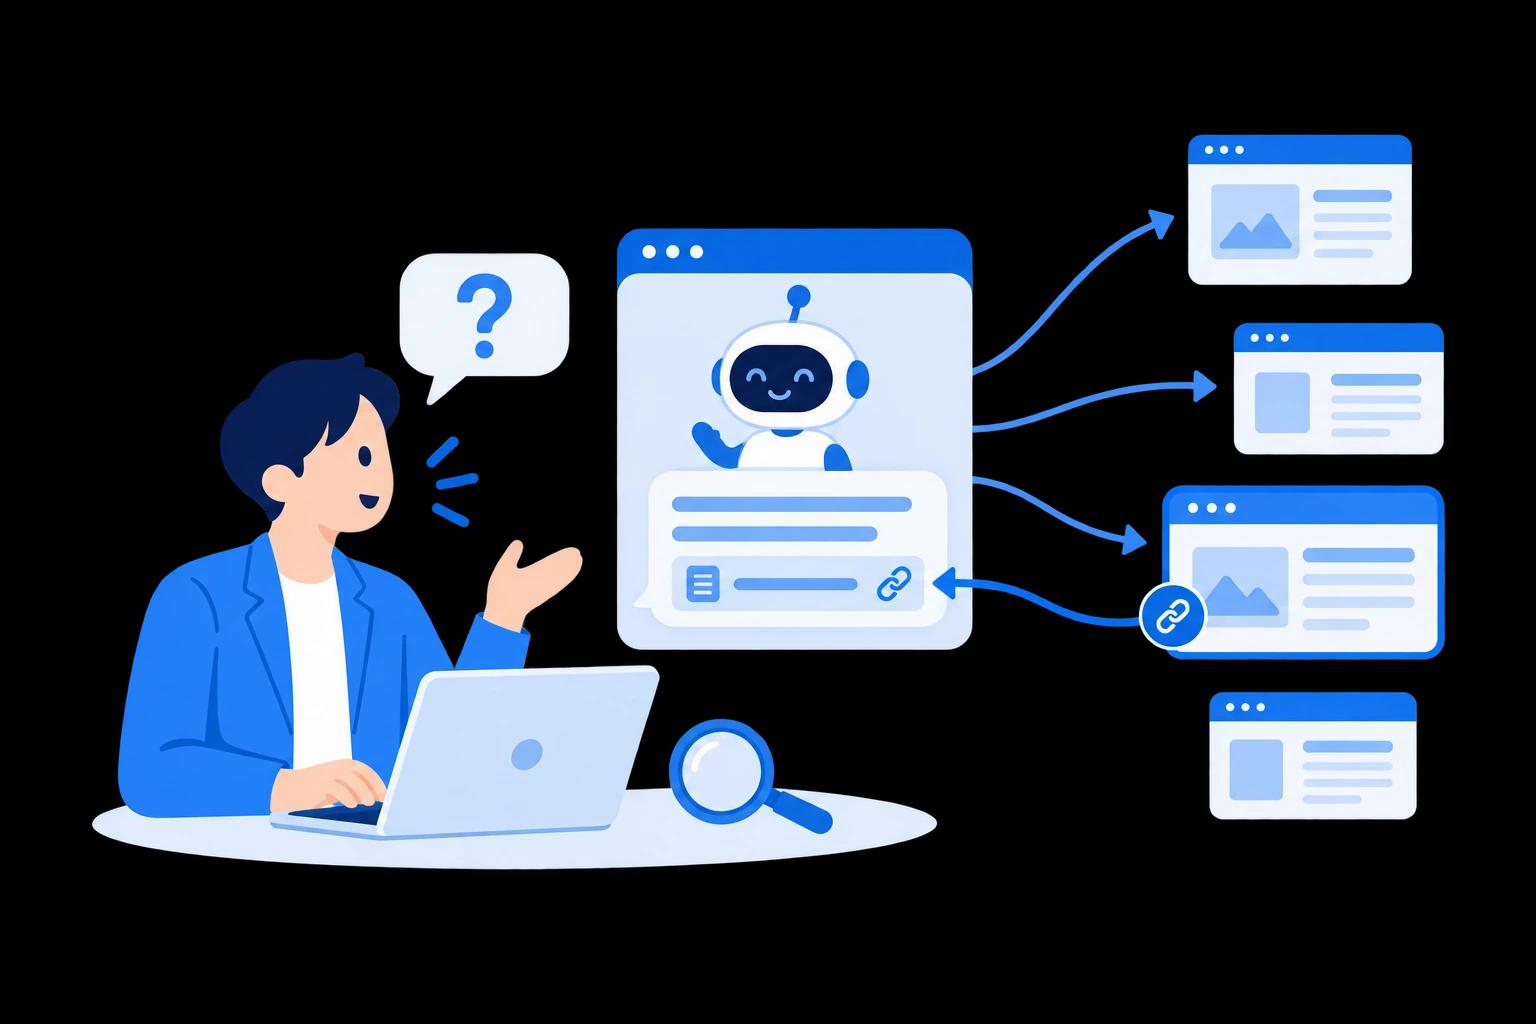
LLMO(大規模言語モデル最適化。GEO・AIOとも呼ばれます)は、ChatGPTやClaude、GoogleのAI Overviewsのような「AIが答えを書く検索」で、自社のページが根拠として選ばれるように整える取り組みです。
この記事では、SEOとLLMOの違い、AIが質問を調べる仕組み、そして今日から手を付けられる対策を解説します。
LLMOとは?SEOとの違い
SEO(検索エンジン最適化)は、Googleの検索結果に並ぶ10件のリンクの中で、上位に表示されることを目指す取り組みでした。
LLMOが相手にするのは、リンクの一覧ではなくAIが書いた回答文です。読者はAIに質問し、AIが複数のページを読んでまとめた答えを受け取ります。根拠に選ばれたページは、回答文に出典のリンクとして添えられます。
ここで目指すのは「上位に並ぶこと」ではなく、AIが回答文を書くときに、根拠として選ばれることです。
とはいえ、SEOが不要になるわけではありません。 GoogleのAI OverviewsやAI Modeは、Googleの検索インデックスに載っているページから根拠を選びます。 ChatGPTやClaudeのWeb検索も、検索エンジンの結果や自前のクローラーで集めたページを読みに行きます。 LLMOは、SEOで作った土台の上に「AIに読まれ、選ばれるための工夫」を足すものと考えるのが実態に近いでしょう。
AIで調べる人が増えると、何が変わるのか
調べものの入口が、Googleの検索窓だけではなくなりました。「〜とは」「〜の選び方」のような質問をChatGPTやClaudeに直接投げる人もいれば、Googleで検索した結果の一番上に出るAI Overviewsだけを読んで済ませる人もいます。
このとき起きる変化は、大きく2つあります。
- 検索結果で上位でも、AIの回答に出てこないことがある。AIは検索順位をそのまま写すのではなく、質問に答えるのに必要な部分を、複数のページから拾って組み立てます
- AIの回答の中で名前が出なければ、比較の候補にも入らない。「〜に強い会社は?」と聞かれたAIが3社を挙げたとき、そこに入らなかった会社は、読者がページを開く前に候補から外れます
AIは1つの質問を、複数の検索に分けて調べる
LLMOの対策を考えるうえで、最も押さえておきたいのがAIの調べ方です。 GoogleはAI ModeやAI Overviewsの説明の中で、読者の質問を答えに必要な観点ごとの問いに分け、それぞれを検索してから1つの回答にまとめる仕組みを「クエリ ファンアウト(query fan-out)」と呼んでいます。
ChatGPTやClaudeも、1つの質問に対して検索を何度か繰り返すことがあります。この記事では、分けられたそれぞれを「分解された問い」と呼びます。
例えば、読者が「中小企業が受発注システムを入れるときの注意点は?」と聞いたとします。 AIはこれを、例えば次のような問いに分けて調べることがあります。
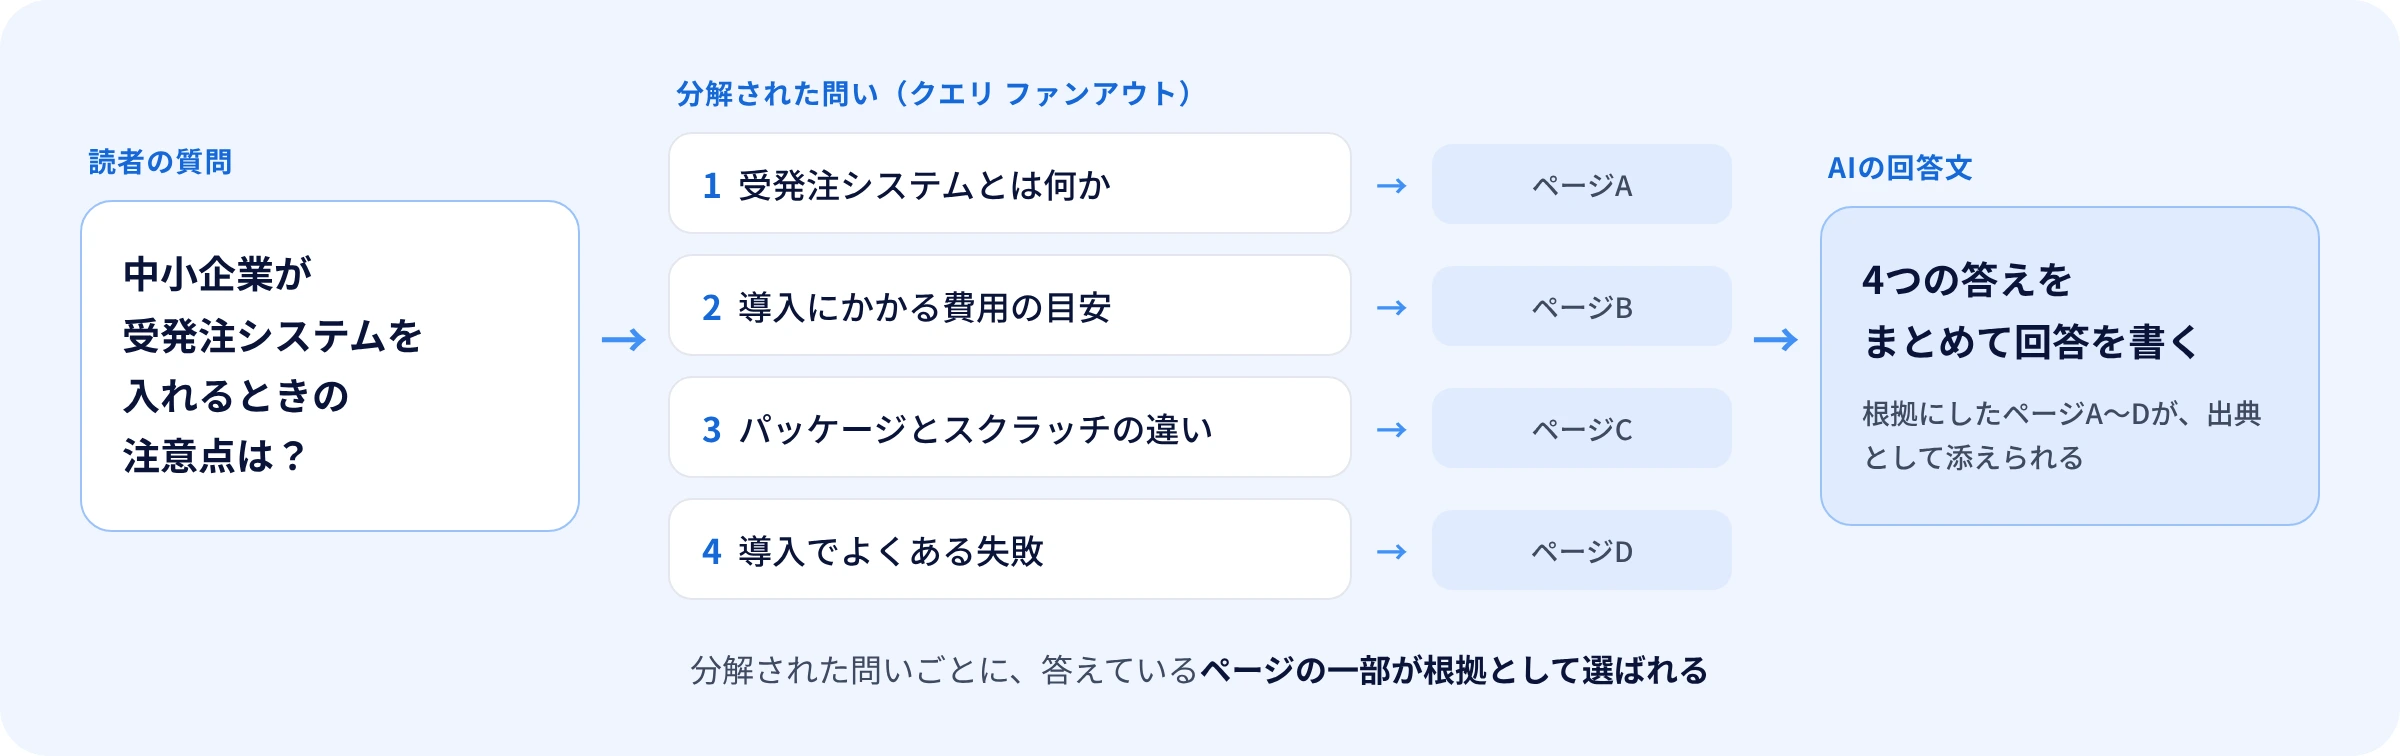
- 受発注システムとは何か
- 導入にかかる費用の目安
- パッケージとスクラッチ開発の違い
- 導入でよくある失敗
このとき根拠に選ばれやすいのは、元の質問に答えたページ全体より、分解された問いにそのまま答えている部分だと考えられます。「受発注システムの注意点」を1本の長い文章で語っていても、費用の目安やよくある失敗がどこに書いてあるかが分かりにくければ、その問いの根拠は別のページから選ばれるかもしれません。
そのため、読者の質問とAIによる分解を先に予測し、分解された問いごとに答えの節を用意しておくことが対策の中心になります。
受発注システムそのものの話は「受発注業務はなぜDXが進みにくいのか」で解説しています。
LLMOの対策
1. 来るはずの質問を、分解された問いの形で書き出す
まず、自社のサービスについて読者がAIに聞きそうな質問を書き出します。営業の場で実際に聞かれる質問や、問い合わせフォームに書かれた文面が一番の材料です。
次に、それぞれの質問をAIがどう分解しそうか(クエリ ファンアウトの先)を書き出します。「〜とは」「費用は」「〜との違いは」「失敗する原因は」「どう選ぶか」のように、答えに必要な観点で分けると、ページに足りない問いが見えてきます。
ChatGPTやClaudeに実際に自社の領域の質問を投げ、回答文に添えられた出典を見るのも有効です。どんな問いに、どんなページが根拠として選ばれているかが分かります。
2. 問いごとに、答えを1か所で言い切る
分解された問いには、ページのどこか1か所で、短く言い切る形で答えます。
- 見出しを問いの形にする。「費用の目安」より「受発注システムの導入費用はいくらか」のほうが、分解された質問とそのまま対応します
- 見出しの直後の1〜2文で答える。前置きや背景から入ると、AIが答えの部分を切り出しにくくなります
- 同じ問いへの答えを複数のページに散らさない。問いごとに薄いページを量産するのではなく、関連する問いは1本のページの節として束ねます
3. 構造化データで、ページの中身をAIに明示する
構造化データ(JSON-LD)は、ページに何が書いてあるかを、機械が読める形で添える仕組みです。会社(Organization)、サービス(Service)、よくある質問(FAQPage)、記事の書き手と公開日(Article)などを、決まった形式で記述します。
構造化データを入れたからといって、AIに必ず引用されるわけではありません。 GoogleもAI Overviewsに出るために特別な構造化データは要らないとしています。それでも、会社名・サービス名・書き手・更新日のような事実を取り違えられにくくするために、入れておく価値はあります。
注意したいのは、構造化データの中身をページに表示されている本文と一致させることです。本文にないFAQを構造化データにだけ書くと、Googleのガイドライン違反になります。また、FAQPageを入れても、検索結果にFAQのリッチリザルトが出るのは現在、政府や医療系の一部のサイトに限られています。
4. AIのクローラーを拒否していないか確かめる
AIがページを根拠に選ぶには、まずそのページを読めなければなりません。主なAIサービスは、それぞれ専用のクローラー(ページを読みに来るプログラム)を持っています。
- Google(AI Overviews・AI Mode): 通常の検索と同じGooglebot。検索に出ていれば対象になります
- ChatGPT: 検索結果に出すためのOAI-SearchBotと、ユーザーの依頼でページを読むChatGPT-User
- Claude: 検索用のClaude-SearchBotと、ユーザーの依頼でページを読むClaude-User
- Perplexity: 検索用のPerplexityBotと、ユーザーの依頼でページを読むPerplexity-User
robots.txt やCDN・WAFの設定で、これらを意図せずブロックしていることがあります。特に、セキュリティ対策の一環で「ボットをまとめて遮断する」設定を入れている場合は、AIの検索用クローラーまで止まっていないかを確かめます。
なお、AIの学習用クローラー(OpenAIのGPTBot、AnthropicのClaudeBotなど)は検索用とは別です。学習用だけを拒否し、検索用は許可する設定もできます。なお、GoogleのGoogle-Extendedを拒否しても、AI Overviewsの対象からは外れません。また、ユーザーの依頼でページを読むクローラーには、robots.txtが適用されない場合があると案内されています。
5. サイトの索引をAIに渡す(llms.txt)
llms.txtは、サイトの概要と主要なページの一覧を、AIが読みやすいMarkdownでまとめたファイルです。サイトのルートに /llms.txt として置きます。
llms.txtは、まだ提案段階の取り決めです。 GoogleはAI機能に表示されるためにAI用のテキストファイルは不要としており、ほかのAIサービスがどこまで読んでいるかも公表されていません。手間は小さいので、サイトの紹介文を整理する作業も兼ねて用意しておく、くらいの位置づけがよいでしょう。
弊社の取り組み
弊社のコーポレートサイトでも、ここで挙げた対策を実装しています(llms.txtも公開しています)。
- 主要なサービスページに、そのサービスの定義とよくある質問を置き、表示する質問と構造化データ(FAQPage)を同じデータから出しています
- 会社の紹介文を、ページの説明文・構造化データ・llms.txtで同じ文に揃えています
- コラム記事は、読者が検索する問いごとに1本ずつ書き、見出しの直後に答えを置いています
LLMOの対策は、一度設定して終わりではなく、サービスやページが増えるたびに問いの書き出しと構造化データを更新し続ける必要があります。
弊社の「マルゴトLLMO」では、こうした対策を、AIの回答の調査から問いの設計、ページの改善、構造化データやクローラー設定の実装、流入・問い合わせの計測まで伴走しています。
まとめ
- 自社の領域でAIに聞かれそうな質問を書き出しましょう。
営業や問い合わせで実際に聞かれた言葉が、一番の材料です。 - その質問を、AIが分解しそうな小さな問いに分けましょう。
「とは」「費用」「違い」「失敗」「選び方」の観点で分けると、ページに足りない問いが見えます。 - 問いごとに、見出しと直後の1〜2文で答えを言い切りましょう。
1つの問いには1つのページで答えます。 - 構造化データを、本文と一致させて入れましょう。
会社・サービス・FAQ・記事の事実をAIに取り違えられないようにします。 - AIの検索用クローラーを止めていないか確かめましょう。
robots.txtだけでなく、CDNやWAFのボット対策の設定も見直します。
AIに選ばれるための問いの洗い出しから、ページ構成の見直し、構造化データやクローラー設定の実装まで、弊社で伴走しています。自社サイトのLLMO対策をどこから始めればよいか迷っている方は、マルゴトLLMOのお問い合わせからお気軽にご相談ください。
ライター
feeed編集部 / フィード株式会社
フィード株式会社のコラム編集部です。PoC開発・新規事業開発・受託開発の現場で得たことを、発注する側の判断に役立つ形で書いています。